

전체 학습 데이터의 약 31%만 골라 써도 성능은 거의 그대로 유지된다. GPU(그래픽처리장치)를 더 사들이지 않고도 기존 장비로 AI를 더 빠르고 싸게 만들 수 있다는 의미다.
거대언어모델은 챗GPT처럼 방대한 텍스트를 학습해 사람의 말을 이해하고 답하는 AI다. 다만 범용으로 만들어진 모델을 그대로 쓰면 의료 상담이나 코딩 지원처럼 특정 분야에서는 정확도가 떨어질 수 있다.
이때 특정 분야의 데이터를 추가로 학습시켜 모델을 그 분야에 특화시키는 과정을 '미세조정(파인튜닝)'이라고 부른다. 문제는 이 미세조정 과정에 시간과 전력을 많이 쓰는 GPU(그래픽처리장치, AI 연산을 전담하는 고성능 반도체)가 대량으로 필요하다는 점이다.
최근 수년간 AI 업계에서는 "GPU가 곧 돈"이라는 말이 나올 정도로 GPU 확보 경쟁이 치열했다. 고성능 GPU 한 대 가격이 수천만 원을 넘고, 이를 수십~수백 대씩 묶어 돌리는 데 드는 전기요금도 만만치 않다.
이 때문에 거대 빅테크 기업이 아닌 일반 기업이나 스타트업은 GPU 확보 비용 부담 때문에 자체 맞춤형 AI 개발을 포기하는 경우가 많았다. 같은 GPU로 더 짧은 시간에 더 많은 학습을 끝낼 수 있는 기술이 있다면, 이런 비용 장벽을 낮추는 효과를 기대할 수 있다.
KAIST 전산학부 이재길 교수 연구팀은 이 문제를 해결하기 위해 'CluSTER(클러스터)'라는 기술을 개발했다. 이름 그대로 데이터를 비슷한 성격별로 '묶어서(클러스터링)' 학습시키는 방식이다. 쉽게 비유하면, 시험공부를 할 때 비슷한 유형의 문제를 묶어 풀면 겹치는 개념을 반복해서 배우지 않아도 되는 것과 같은 원리다.
연구팀은 겉보기에는 전혀 다른 문제라도 '비슷한 해결 능력'을 가르치는 데이터라면 같은 그룹으로 분류하는 방법을 고안했다. 이렇게 비슷한 그룹으로 묶인 데이터 중에서는 가장 학습 효과가 큰 데이터만 골라, 여러 대의 GPU에 고르게 나눠 분담시킨다. 비슷한 내용을 여러 GPU가 각자 중복으로 연산하느라 시간을 낭비하는 비효율을 없앤 것이 핵심이다.
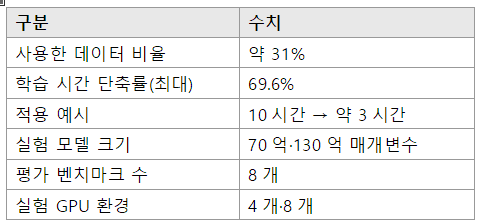
연구팀은 이 기술의 효과를 검증하기 위해 매개변수(모델의 크기를 결정하는 값) 70억 개와 130억 개짜리 모델 두 종류를 코딩·의료 분야 데이터셋 3종으로 미세조정했다. 그 결과 전체 데이터의 약 31%만 사용해도 전체 데이터를 다 쓴 경우와 거의 같은 성능이 나왔다.
학습 시간은 최대 69.6% 줄었는데, 이를 적용하면 기존에 10시간 걸리던 미세조정 작업이 약 3시간으로 단축되는 셈이다. 연구팀은 이 결과를 총 8개의 성능 평가 지표(벤치마크)로 검증했으며, GPU 4개를 쓰는 환경뿐 아니라 8개를 쓰는 환경에서도 기존 방법보다 나은 성능을 확인했다고 밝혔다.
이재길 교수는 "AI 학습 효율을 높이려면 GPU를 많이 쓰는 것만큼이나 학습에 쓸 데이터를 지능적으로 고르는 것이 중요하다"며 "이번 기술로 기존에 보유한 GPU 자원을 더 효율적으로 활용할 수 있게 됐다"고 설명했다.
연구에는 KAIST 박사과정 김현진 연구원이 제1저자로, 이 교수가 교신저자로 참여했으며 토론토대 박사후연구원과 KAIST 데이터사이언스대학원 석사과정생도 공동 연구자로 이름을 올렸다. 이 연구는 지난 10월 자연어처리 분야의 권위 있는 국제학회 'EMNLP(자연어처리 경험적 방법론 학회) 2026'에서 발표됐다. EMNLP는 세계 각지의 AI 연구자들이 매년 모여 언어 AI 분야의 최신 성과를 공개하고 검증받는 자리로, 이번 발표를 통해 CluSTER 기술의 학술적 완성도도 국제적으로 인정받은 셈이다.
여러 GPU에 작업을 나눠 처리하는 것을 '데이터 병렬화'라고 하는데, 기존 방식에서는 GPU마다 서로 겹치는 내용을 모르고 각자 비슷한 데이터를 따로 학습하는 비효율이 발생하기 쉬웠다. CluSTER는 이런 중복을 미리 걸러내고 GPU 사이에 작업을 균형 있게 나눠주는 '교통정리' 역할을 한다고 볼 수 있다. 연구팀에 따르면 이런 균형 배분 덕분에 특정 GPU만 유난히 오래 작업하다 나머지 GPU가 노는 시간 낭비도 줄어든다.
이번 기술이 상용화되면 당장 효과를 볼 수 있는 분야는 기업 맞춤형 고객 상담 AI나 의료 전문가를 위한 정보 검색 지원 AI처럼, 특정 목적에 맞춘 '전문가형 AI' 개발이다. 거대 빅테크만큼 GPU를 많이 보유하지 못한 국내 중소 AI 기업이나 스타트업도 적은 비용으로 특화 AI를 개발할 길이 열리는 것이다.
연구에 들어가는 비용 대부분이 GPU 가동 시간에서 나오는 만큼, 학습 시간이 줄어든다는 것은 곧 전기요금과 서버 임대료 등 실제 개발비 절감으로 직결된다는 의미이기도 하다.
다만 연구팀이 검증한 모델 규모가 70억~130억 매개변수급으로, 최근 공개되는 1000억 매개변수 이상의 초대형 모델에도 똑같은 효율이 나타날지는 추가 검증이 필요하다. 데이터를 묶고 고르는 데도 별도의 연산이 들어가기 때문에, 데이터 양이 아주 적은 경우에는 오히려 효율이 떨어질 가능성도 배제할 수 없다.
연구팀은 앞으로 더 큰 모델과 다양한 분야의 데이터셋에 이 기술을 적용해 범용성을 넓혀갈 계획이라고 밝혔다. 이번 연구는 과학기술정보통신부 산하 정보통신기획평가원(IITP)의 소프트웨어 스타랩 사업 지원을 받아 수행됐다. 국내 AI 개발 생태계 전반의 GPU 의존도를 낮추는 데 이번 기술이 실질적인 도움이 될지 업계의 관심이 모인다.


댓글
(0)